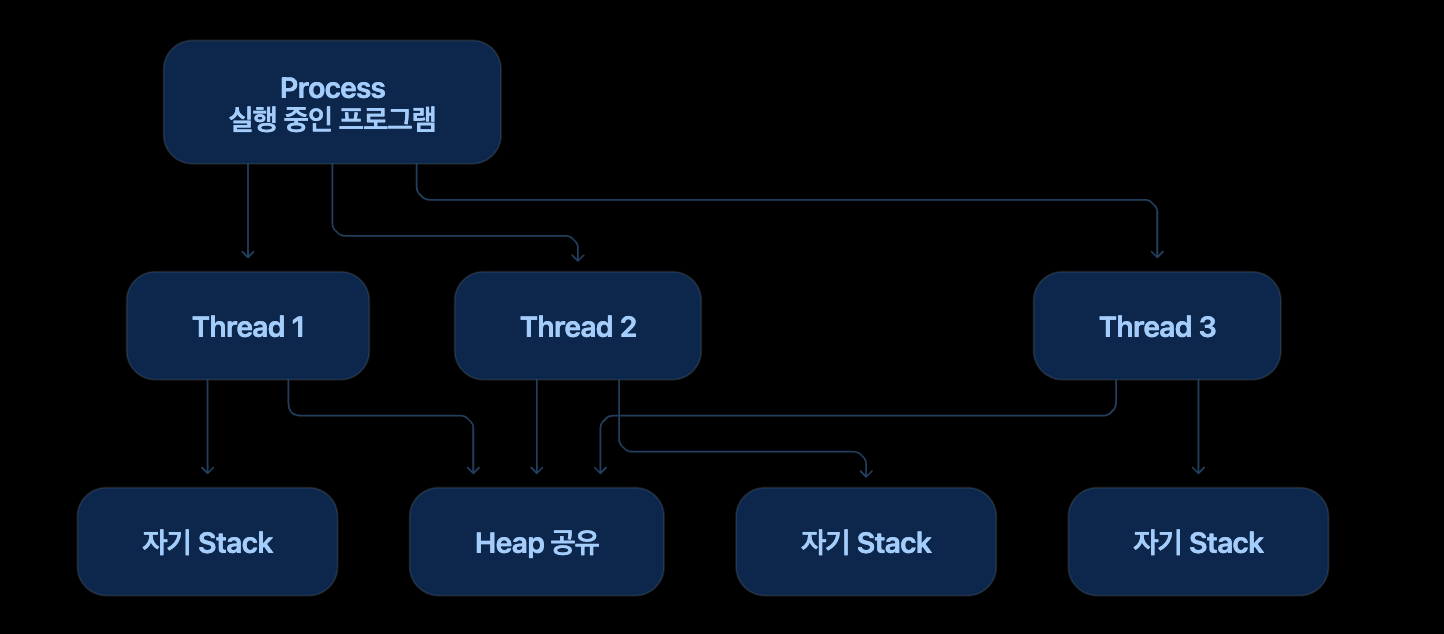
1️⃣ 싱글 스레드
하나의 프로세스에서 스레드 하나만 사용하는 방식이다.
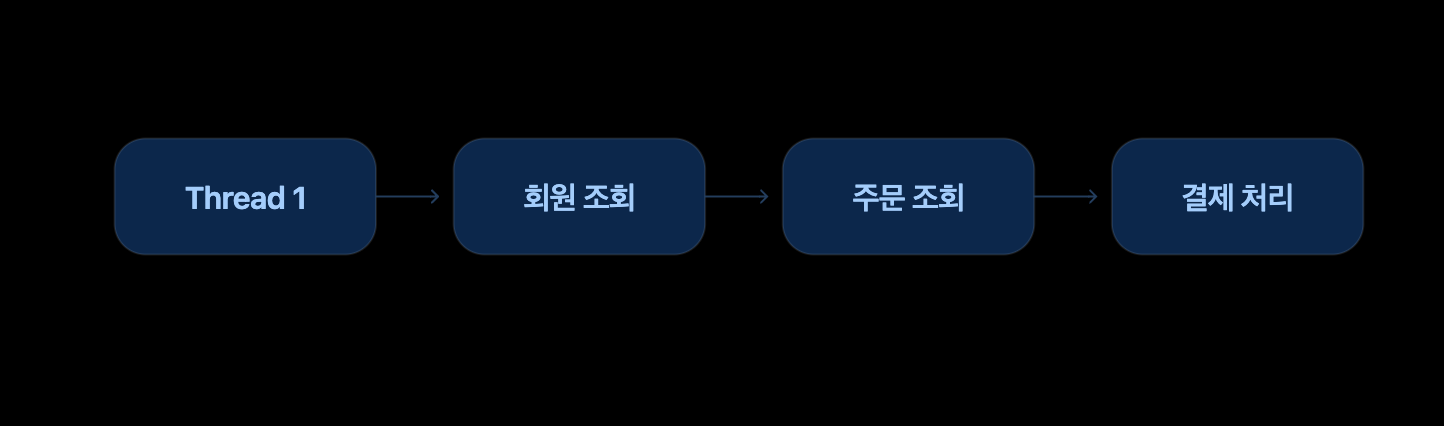
예를 들어 해야 할 작업이 다음과 같이 3개 있다고 해보자.
- 회원 조회
- 주문 조회
- 결제 처리
싱글 스레드라면 기본적으로 순서대로 처리한다.
(1) 장점
구조가 단순하다.
공유 데이터를 여러 스레드가 동시에 변경하는 일이 없기 때문에 다음 문제를 고민할 일이 상대적으로 적다.
- Race Condition
- 동기화
- Deadlock
- Lock
예를 들어:
int count = 0;

count++;
스레드가 하나라면 count++를 누가 동시에 건드릴 걱정을 거의 할 필요가 없다.
(2) 단점
작업 하나가 오래 걸리면 뒤의 작업이 모두 기다린다.
예를 들어:
Thread

요청 A ─────────────── 5초
                     요청 B ── 0.1초
A가 DB나 외부 API를 5초 동안 기다리고 있으면 B는 바로 처리할 수 있는데도 기다려야 할 수 있다.
2️⃣ 멀티 스레드
하나의 프로세스 안에서 여러 스레드가 동시에 작업을 처리하는 방식이다.
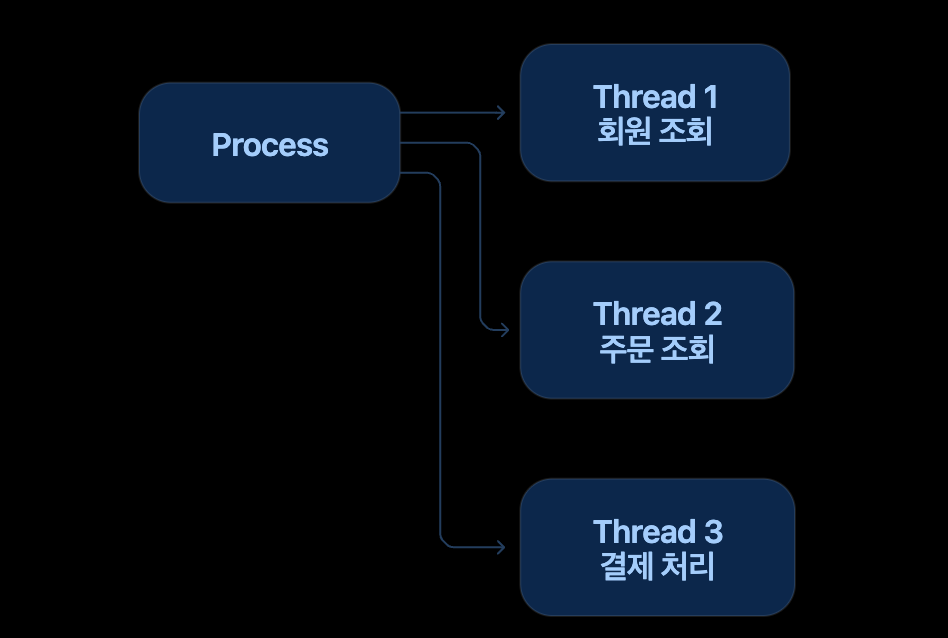
개념적으로는 다음처럼 작업할 수 있다.
Thread 1 : 회원 조회 ──────────

Thread 2 : 주문 조회 ───────

Thread 3 : 결제 처리 ─────────
따라서 여러 요청을 동시에 처리하는 서버에서 매우 유용하다.
예를 들자면,
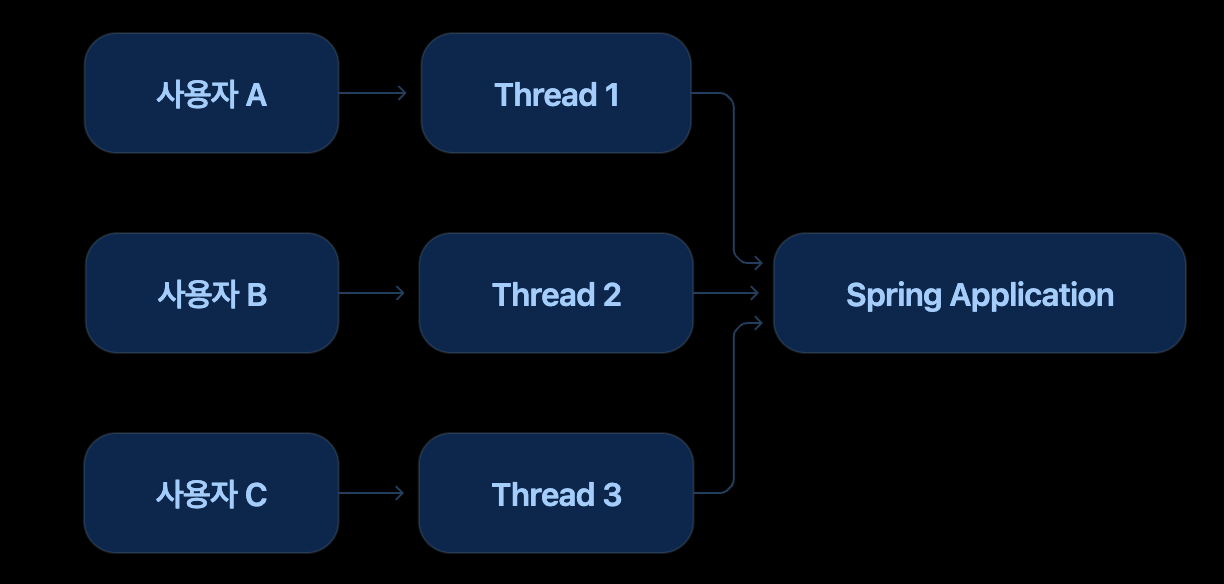
클라이언 3명이 다음과 같은 요청을 보낸다고 가정해보자
사용자 A → GET /games
사용자 B → POST /games
사용자 C → POST /games/1/join
Tomcat 같은 WAS는 보통 여러 개의 스레드를 준비해두고 요청을 처리한다.
(1) CPU 코어와 스레드의 차이
예를 들어 CPU가 4코어라고 해보자.
Core 1
Core 2
Core 3
Core 4
스레드가 100개 있을 수도 있다.
Thread 1
Thread 2
Thread 3
...
Thread 100
CPU가 이 스레드들을 번갈아 실행한다.
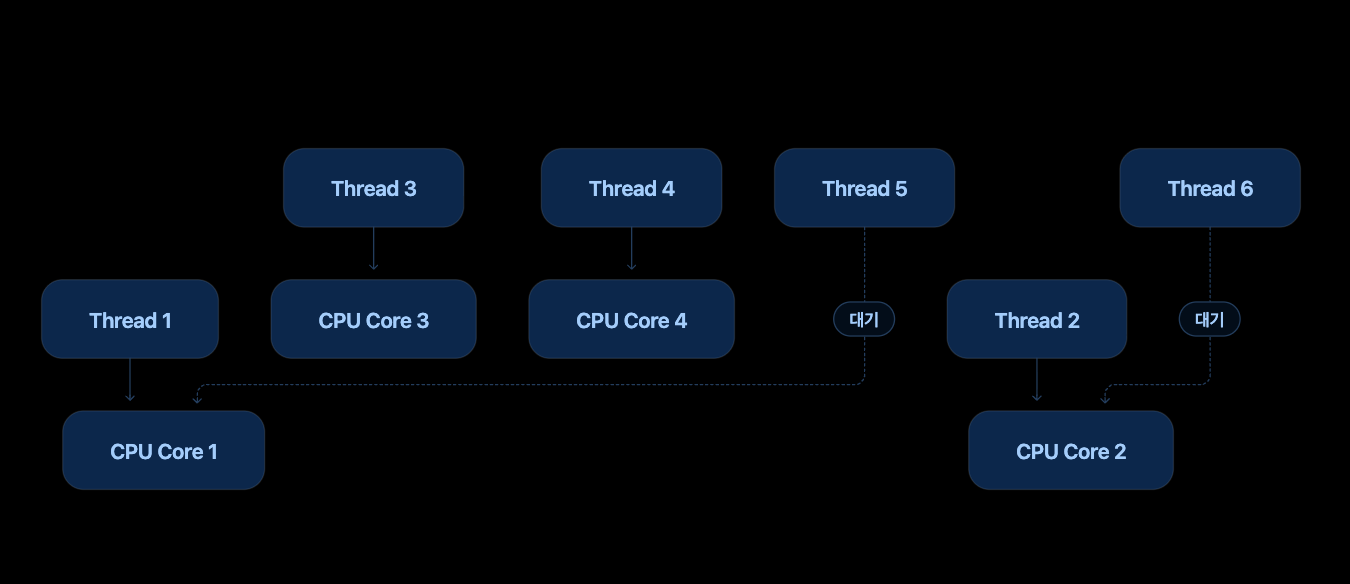
스레드 수 = CPU 코어 수는 틀린 말이다.
(2) 동시성과 병렬성
동시성(Concurrency)
여러 작업을 번갈아가면서 처리해서 동시에 실행되는 것처럼 보이는 현상이다.
CPU 코어가 하나라고 가정해보자.
시간 →

Thread A
─────     ─────

Thread B
     ─────     ─────
CPU가 매우 빠르게
A → B → A → B를 반복한다.
사용자는 동시에 실행되는 것처럼 느낀다.
병렬성(Parallelism)
실제로 여러 CPU 코어에서 동시에 실행되는 것이다.
Core 1 → Thread A 실행

Core 2 → Thread B 실행
따라서 정리하면:
동시성
여러 작업을 동시에 다루는 것

병렬성
여러 작업을 실제로 동시에 실행하는 것
멀티스레드라고 해서 항상 병렬 실행되는 것은 아니다.
3️⃣ 멀티 스레드의 위험성
스레드들은 프로세스의 Heap 영역을 공유한다.
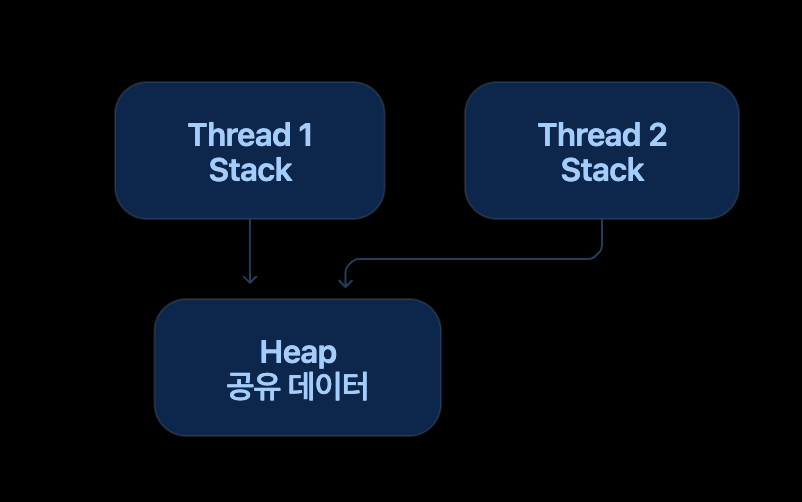
그래서 다음 코드가 있다고 가정해보자.
int count = 0;

count++;
두 스레드가 동시에 실행한다고 기대한다.
Thread 1 → +1
Thread 2 → +1

결과 = 2
그런데 실제로는 count++가 한 번의 연산이 아니다.
대략:
1. count 읽기
2. count + 1
3. count 저장
라고 생각할 수 있다.
두 스레드가 동시에 접근하면:
초기 count = 0

Thread A: count 읽음 → 0
Thread B: count 읽음 → 0

Thread A: 0 + 1 → 1
Thread B: 0 + 1 → 1

Thread A: count = 1
Thread B: count = 1
최종 결과:
1기대했던:
2가 아니다.
이걸 Race Condition(경쟁 상태) 이라고 한다.
| 구분 | 싱글 스레드 | 멀티 스레드 |
| 실행 흐름 | 1개 | 여러 개 |
| 구현 난이도 | 낮음 | 높음 |
| 동시 요청 처리 | 불리함 | 유리함 |
| 공유 데이터 문제 | 적음 | 발생 가능 |
| Race Condition | 거의 없음 | 발생 가능 |
| Lock 고려 | 적음 | 필요할 수 있음 |
| Context Switching | 적음 | 발생 |
| 서버 환경 | 제한적 | 일반적으로 많이 사용 |
💡 멀티스레드라고 무조건 빠른 것이 아니다.
스레드를 많이 만들면 무조건 성능이 올라갈 것 같지만 그렇지 않다.
예를 들어 CPU 코어가 4개인데 CPU 연산을 하는 스레드가 10,000개면 CPU가 계속 스레드를 교체해야 한다.
Thread A 실행
↓
Thread A 상태 저장

Thread B 실행
↓
Thread B 상태 저장

Thread C 실행
...
이 과정을 Context Switching이라고 한다. Context Switching도 비용이다.
따라서:
스레드 증가
   ↓
동시 처리 능력 증가

하지만

스레드 지나치게 증가
   ↓
Context Switching 증가
   ↓
메모리 사용 증가
   ↓
오히려 성능 저하
가 될 수 있다.
4️⃣ 멀티 프로세스
멀티 프로세스는 말 그대로 여러 개의 프로세스를 동시에 실행하는 방식이다.
예를 들어
Chrome
 ├─ Process A
 ├─ Process B
 └─ Process C
처럼 하나의 프로그램이 여러 프로세스를 띄울 수도 있다. 멀티스레드와 가장 큰 차이는 메모리 공유 여부다.
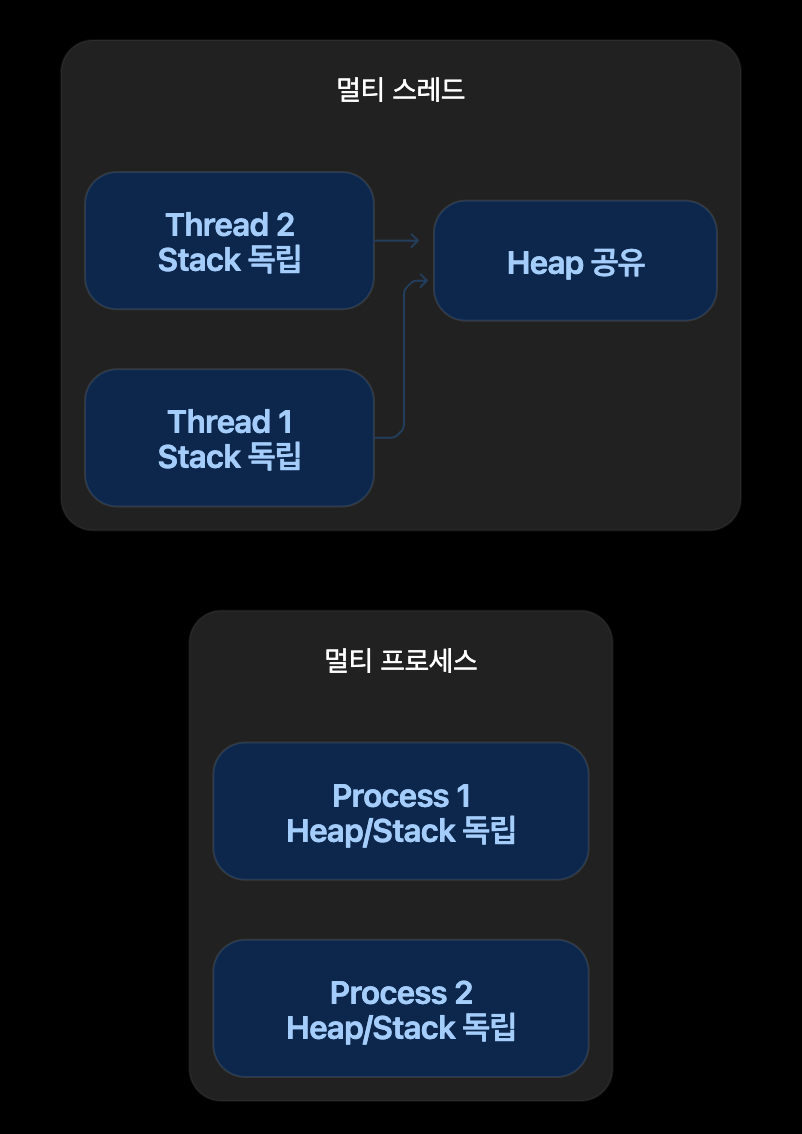
멀티 프로세스
각 프로세스는 기본적으로 자기 메모리 공간을 따로 가진다.
Process A
- Code
- Data
- Heap
- Stack

Process B
- Code
- Data
- Heap
- Stack
그래서 A 프로세스의 변수를 B 프로세스가 그냥 접근할 수 없다.
반면 멀티스레드는:
Process
 ├─ Thread A → Stack A
 ├─ Thread B → Stack B
 └─ Heap → 공유
처럼 Heap 같은 프로세스 자원을 공유한다. 이 차이 때문에 장단점이 갈린다.
| 구분 | 멀티프로세스 | 멀티스레드 |
| 메모리 | 프로세스별 독립 | 같은 프로세스 메모리 공유 |
| 안정성 | 높음 | 상대적으로 낮음 |
| 데이터 공유 | 어려움 | 쉬움 |
| Context Switching 비용 | 큼 | 상대적으로 작음 |
| 생성 비용 | 큼 | 상대적으로 작음 |
| 장애 영향 | 한 프로세스 장애가 다른 프로세스에 덜 영향 | 한 스레드 문제로 프로세스 전체 영향 가능 |
| 통신 | IPC 필요 | 공유 메모리 사용 가능 |
예를 들어 멀티프로세스에서는 Process A가 죽어도 Process B는 살아 있을 수 있다.
Process A ❌

Process B ✅

Process C ✅
그래서 격리성과 안정성이 좋다. 하지만 프로세스마다 메모리를 별도로 사용하기 때문에 무겁다.
백엔드에서는 다음 정도로 연결해서 이해하면 좋다.
예를 들어 서버를 여러 개 띄우는 것도 큰 관점에서는 여러 프로세스라고 볼 수 있다.
Server Process 1
Spring Boot

Server Process 2
Spring Boot

Server Process 3
Spring Boot
로드밸런서가 있으면:
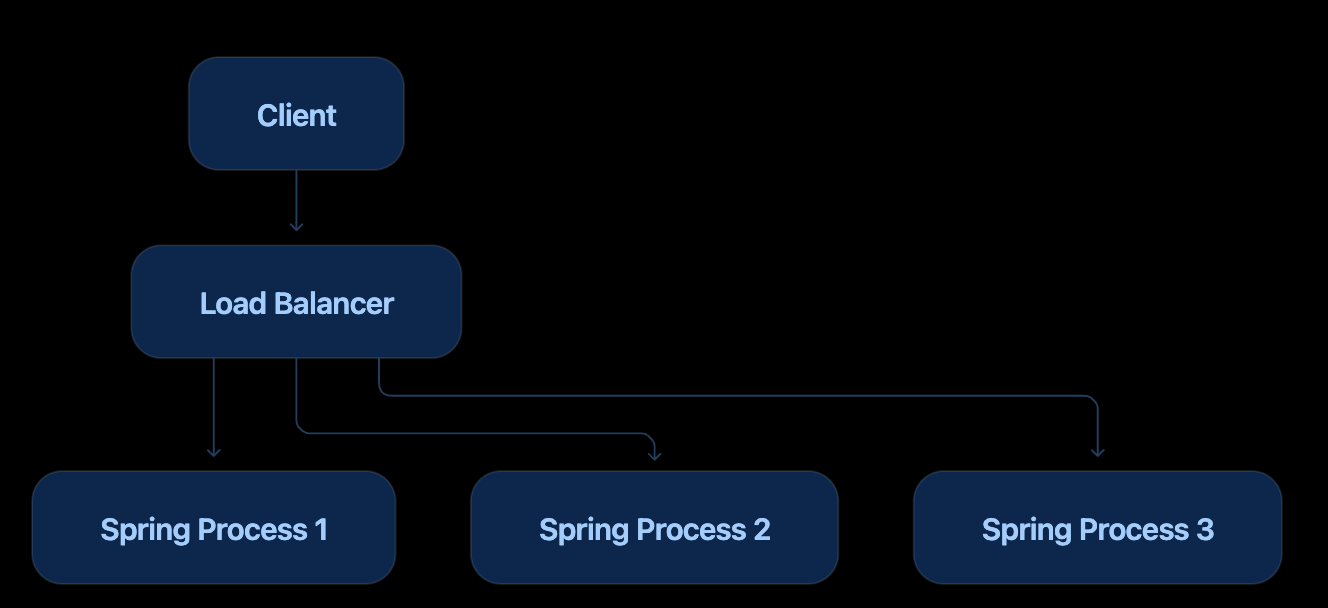
각 Spring Boot 애플리케이션은 별도의 JVM 프로세스다.
그리고 각각의 JVM 내부에서는 다시 여러 스레드가 요청을 처리한다.
즉 실제 백엔드에서는 둘이 같이 등장한다.
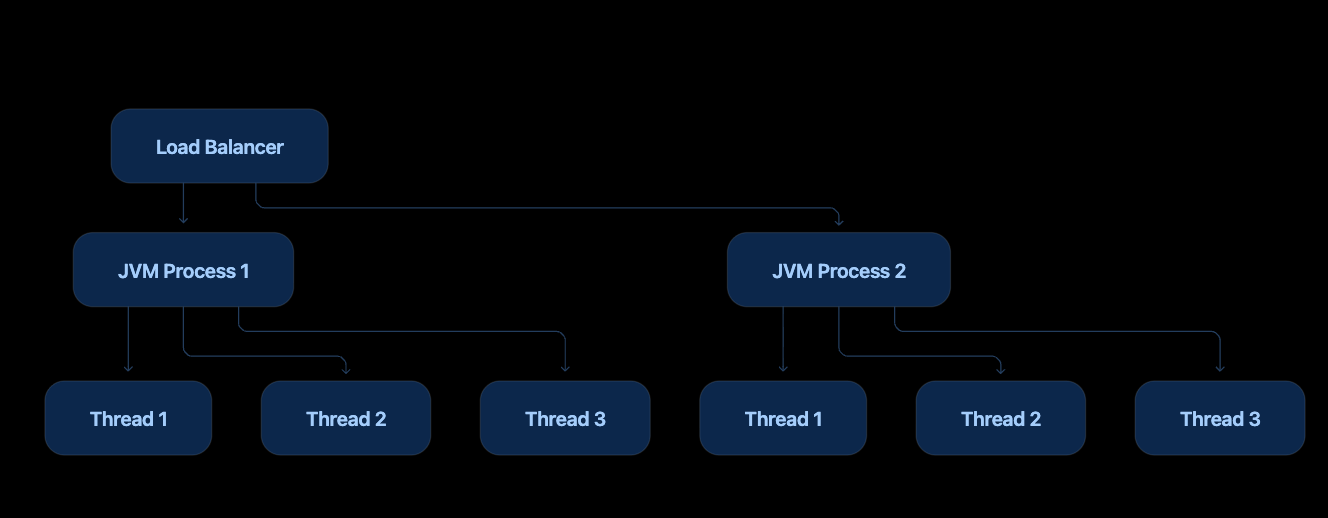
이 구조를 이해하는 게 중요하다.
예를 들어 서버를 2대 띄웠다고 하면:
JVM A
participantCount = 5

JVM B
participantCount = 5
JVM A의 synchronized는 JVM A 내부 스레드끼리만 동기화할 수 있다. JVM B까지 막아주지는 못한다.
그래서 실제 분산환경에서는 단순히:
synchronized만으로 DB 동시성 문제를 해결할 수 없는 경우가 있다.
DB Lock / Redis Distributed Lock 같은 내용과 연결된다.
예를 들어:
사용자 A
 ↓
Server 1
 ↓
DB

사용자 B
 ↓
Server 2
 ↓
DB
Server 1과 Server 2는 서로 다른 프로세스라 JVM 메모리를 공유하지 않는다.
그래서 동시성 제어를 DB 수준에서 한다면 두 서버 모두 같은 DB Lock의 영향을 받을 수 있다.
'CS' 카테고리의 다른 글
| 가상 메모리와 페이징 시스템 (0) | 2026.09.07 |
|---|---|
| 컴퓨터 구조(1) (0) | 2025.12.11 |